Schreiben ist ein "fruchtloses Brot"
Ein Versuch, dem Verfall der Sprache durch KI mit KI entgegenzuwirken
Als Kind habe ich viel gelesen und viele eigene Geschichten geschrieben. Heute komme ich nicht mehr dazu, und Sprache ist für mich mehr ein Mittel zum Zweck als ein Selbstzweck geworden. Immer wieder ertappe ich mich dabei, wie ich versuche, bestimmte geläufige Formulierungen zu benutzen, aber mir fällt nur die Hälfte ein, und für den Rest des Satzes verwende ich ein Wort, das auch irgendwie passt, aber nicht so ganz richtig klingt.
Damit meine ich keine Redewendungen oder Metaphern, sondern Formulierungen, die im allgemeinen Sprachgebrauch und in der Literatur häufig genug vorkommen, dass es komisch klingt, auch nur ein Wort durch ein sehr ähnliches zu ersetzen. Wie sich herausstellt, nennen sich solche Formulierungen "Kollokationen".
Am meisten nerven mich solche Formulierungen, bei denen es eigentlich keinen inhaltlichen Unterschied macht, ein bestimmtes Wort auszutauschen, aber dennoch klingt nur eines so wirklich richtig. Und dieses fällt mir manchmal einfach nicht ein.
Zum Beispiel: Einer Sache "Gewicht beimessen". "Der Richter beschloss, der Aussage besonderes Gewicht beizumessen". Man könnte genauso gut sagen, "besonderes Gesicht zuzuweisen" oder "die Aussage besonders zu gewichten". Aber das klingt irgendwie alles seltsamer.
Ich weiß, dass ich damit nicht alleine bin. Als ich mich mit anderen Menschen in meinem Alter darüber unterhalten habe, stimmte mir ein an dieser Stelle nur anonym aufgeführter Freund zu und traf eine Aussage über eine vermutliche Ursache des Problems, die dieses jedoch sehr gut beschreibt:
„Schreiben ist ein fruchtloses Brot.“
Vermutlich handelte es sich bei diesem Ausdruck um eine Vermischung aus "einer brotlosen Kunst" und "einem fruchtlosen Unterfangen", welche wiederum schöne Beispiele für Kollokationen sind. Zumindest ist mir keine solche Redewendung bekannt und dieser Fehlgriff hätte genauso gut auch von mir stammen können.
Die Rolle von KI
Das Aufkommen von LLMs hat diese Entwicklung bestimmt nicht verbessert, da man beim Schreiben von Prompts nun wirklich nicht auf seine Ausdrucksweise achten muss, und LLMs Sätze so formulieren, wie es in ihren Trainingsdaten vorkommt, auch wenn es sich um eine häufig verwendete, aber dennoch falsch klingende Abwandlung einer Kollokation handelt.
Eine Art Urform der heutigen, schlauen LLMs sind Masked Language Models (MLMs). Diese wurden darauf trainiert, eine Lücke in einem Satz mit dem wahrscheinlichsten Wort zu füllen. Sie können ebenfalls mehrere Vorschläge generieren und zu jedem Vorschlag eine ungefähre Wahrscheinlichkeit angeben, mit der dieser die richtige Lösung ist.
Das hat mich auf gleich zwei Ideen gebracht: Erstens, herauszufinden, wie gut simple MLMs darin sind, das richtige Wort für eine Kollokation zu erkennen. Zweitens, eine simple App zu entwickeln, mit der man sich darin üben kann, Kollokationen richtig zu verwenden, und dabei gegen ein MLM anzutreten.
MLMs für Kollokationen
Getestete MLMs
Um herauszufinden, ob sich ein Sprachmodell als Gegner und als Bewertungssystem eignet, habe ich 322 englische Kollokationen in Lückensätzen getestet. Neben dem ersten Vorschlag habe ich auch geprüft, ob das gesuchte Wort unter den insgesamt fünf Vorschlägen auftaucht.
| Modell | Auf Platz 1 | In den Top 5 | Nur auf Rang 2–5 |
|---|---|---|---|
| DistilBERT | 18,3 % | 39,1 % | 20,8 % |
| BERT-large mit Whole-Word-Masking | 31,7 % | 48,4 % | 16,8 % |
| T5-small | 7,8 % | 10,9 % | 3,1 % |
| FLAN-T5-base | 0,0 % | 0,0 % | 0,0 % |
BERT-large war damit deutlich am brauchbarsten. Trotzdem liegt es bei vielen Kollokationen daneben, ohne völlig unsinnige Antworten zu geben: Statt des gesuchten, festen Ausdrucks schlägt es häufig eine gewöhnlichere oder stilistisch flachere Alternative vor. Aus lodge a complaint wird zum Beispiel file a complaint. Das ist insofern interessant, dass es in dem Spiel um genau diesen Unterschied zwischen „passt irgendwie“ und „klingt wirklich richtig“ gehen soll.
Bei BERT-large taucht die akzeptierte Lösung in fast der Hälfte aller Fälle unter den fünf Vorschlägen auf. In 54 Übungen steht sie lediglich nicht auf Platz eins.
BERT-large ist bei dieser Aufgabe in Wahrheit etwas benachteiligt, weil es darauf trainiert ist, einzelne Tokens vorherzusagen, jedoch kann ein Wort (oder was auch immer in die Lücke gehört) aus mehreren Tokens bestehen. T5 kann im Unterschied zu BERT auch Lücken mit mehreren Tokens füllen, schnitt hier aber überraschend schlecht ab. FLAN-T5 sollte die Lücke auf eine direkte Anweisung hin ausfüllen, gab jedoch meist andere Wörter aus dem Satz zurück. Für die englische Version verwende ich deshalb BERT-large.
Für die deutsche Version kommt entsprechend bert-base-german-cased zum Einsatz, ein auf deutschen Texten vortrainiertes BERT-Modell. Es füllt dieselben maskierten Lücken und liefert die alternativen Antworten für die deutschen Fragen.
Die Pipeline für Kollokationen
Die Kollokationen und ihre Lückentexte liegen getrennt als kleine JSONL-Datensätze vor. Zu jeder Übung gehören der Satz, die Position der Lücke, eine Schwierigkeit und gegebenenfalls mehrere akzeptierte Lösungen, etwa für unterschiedliche Zeitformen. Die Pipeline ersetzt das gesuchte Wort durch eine Maske, lässt BERT die wahrscheinlichsten Ergänzungen berechnen und speichert diese mitsamt ihren Scores.
Aus dem englischen Testbestand wurden 100 Fragen für das Spiel ausgewählt. BERT-large trifft bei dieser Auswahl 69 von 100 Lösungen. Inzwischen gibt es außerdem 100 deutsche Fragen; ein auf Deutsch trainiertes BERT trifft dort 47 von 100 Lösungen. So entstehen statische Daten, die nicht erst beim Spielen berechnet werden müssen: Sie enthalten sowohl die richtige Lösung als auch die plausiblen Alternativen des jeweiligen Modells. Genau diese Daten verwendet anschließend das Lückentext-Spiel.
Das Lückentext-Spiel
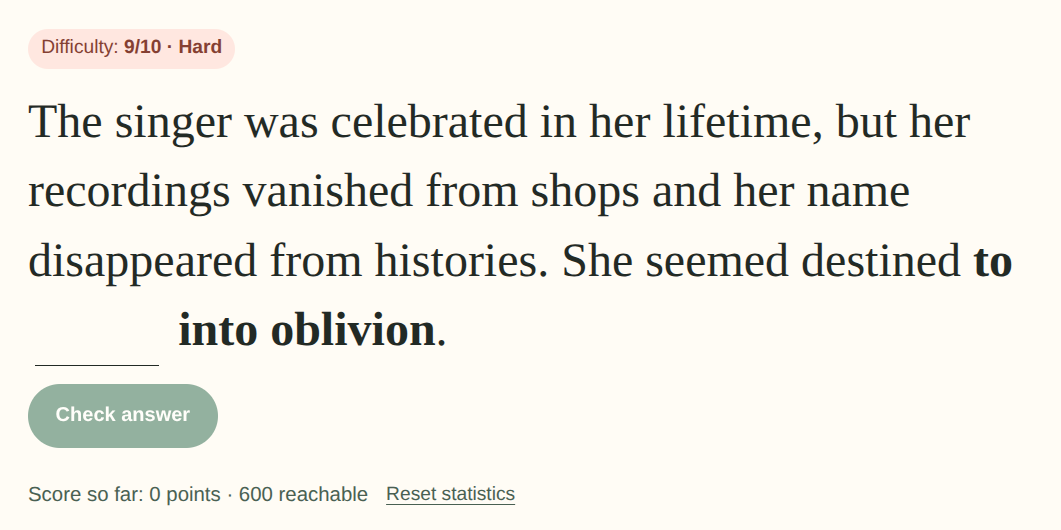
Unter Verwendung der zuvor generierten Daten habe ich dann eine kleine Website entwickelt, bei der Nutzer aufgefordert werden, bei einem Lückentext die Lücken korrekt zu füllen. Pro Frage gibt es 100 Punkte für die richtige Lösung, 75 Punkte für die Lösung, die das MLM für am wahrscheinlichsten hält, und Teilpunkte für Lösungen, die das MLM für ebenfalls möglich hält, proportional zu ihrer Wahrscheinlichkeit.
Fazit
Die von mir getesteten MLMs waren nicht besonders gut darin, Kollokationen zu erkennen. Allerdings handelte es sich nur um kleinere Modelle, die auf einem Desktop-PC ausführbar sind und die Ergebnisse ließen sich mit etwas mehr Aufwand wahrscheinlich deutlich verbessern. Ich habe nicht allzu viel Zeit damit verbracht, dies zu optimieren, da ich mich entschieden habe, die KI-Vorschläge nur für die Bewertung der Spielergebnisse zu verwenden. Ein zu gutes Modell würde vermutlich sowieso eher demotivieren. Das entstandene Spiel ist ein netter Zeitvertreib und auf meiner Website zu finden.
Kommentare
Noch Fragen?